Welches Dokument gilt jetzt?
Steigt der See, hat die verantwortliche Person keine Zeit zum Blättern. Das Hochwasserszenario des Campingplatzes Seeblick besteht aus zehn PDF-Dateien. In Behörden und Krisenorganisationen sind es oft Hunderte, verteilt auf Ordner, Fassungen und Laufwerke. Wer dort im Ernstfall eine bestimmte Massnahme sucht, findet sie oft nicht rechtzeitig.
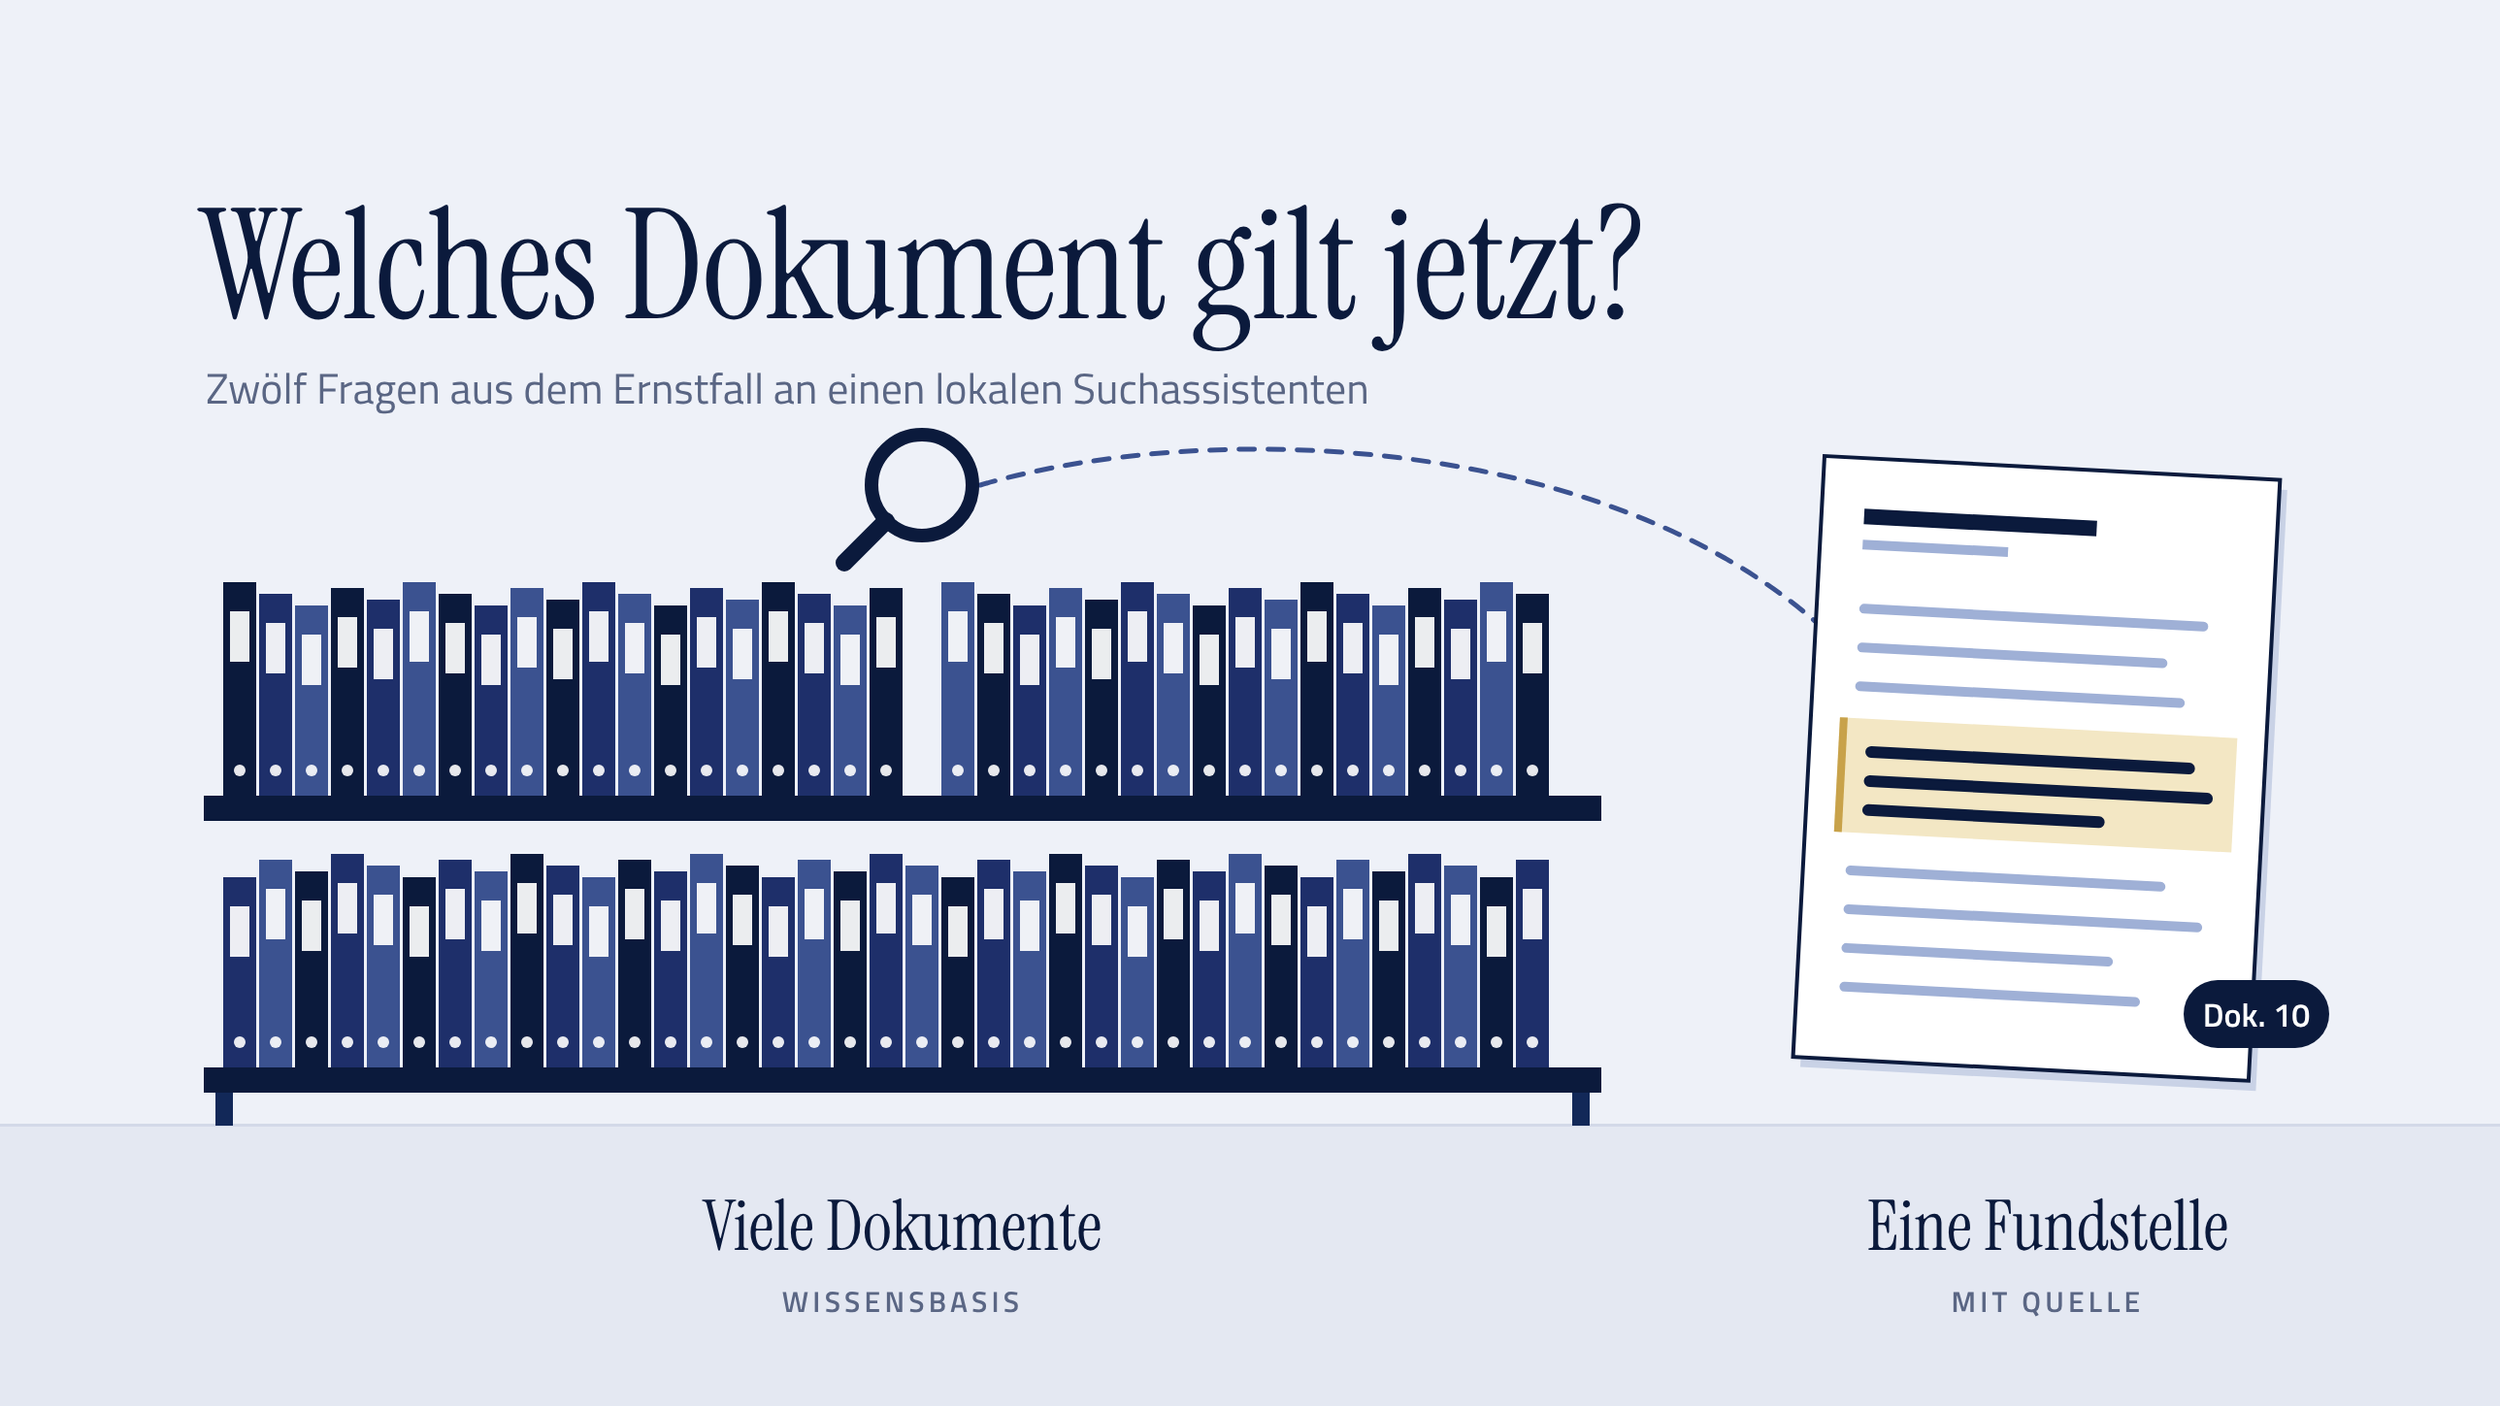
Ein Suchassistent soll diese Suche abkürzen. Auf eine Frage in Alltagssprache nennt er das zuständige Dokument, den Abschnitt und die Kennung der Massnahme. Dieser Test prüft, ob ein lokales KI-Modell das zuverlässig schafft.
Finden, wiedergeben, Quelle nennen
Ein Suchassistent beantwortet Fragen aus einer festgelegten Sammlung von Dokumenten. Zuerst sucht das System die passenden Textstellen. Dann formuliert ein KI-Modell daraus eine Antwort und nennt die Quelle. Der Mensch öffnet die Quelle und prüft.
Beim Word-Dokument aus dem Beitrag "Was in den Speicher passt" setzt das KI-Modell Angaben aus mehreren Dokumenten zu einem neuen Text zusammen. Der Suchassistent zeigt eine Fundstelle. Das verlangt weniger Rechenleistung. Ob dafür ein kleineres KI-Modell reicht, prüft der Test mit zwei Modellen: Qwen 3.5 mit neun Milliarden Parametern und Qwen 3.8 mit 27 Milliarden. Beide laufen auf dem Mac mini M4 Pro mit derselben Kontextlänge.
Deshalb zählt im Test zuerst die Fundstelle. Eine richtige Antwort mit falscher Quelle schickt die verantwortliche Person ins falsche Dokument.
Zwölf Fragen aus dem Ernstfall
Die Fragen sind so gestellt, wie jemand unter Druck fragt: mit einer Beobachtung, ohne Fachbegriff, ohne Dokumentnummer. Grundlage sind die zehn Dokumente des Testfalls, Kapitel 5 in der Fassung 2.3. Zwei Kontrollfragen zielen auf eine leere Zeile und auf einen Begriff, den der Plan nicht kennt.
| Nr. | Frage | Erwartete Fundstelle |
|---|---|---|
| 1 | Das Wasser steht an der zweiten Markierung. Was gilt jetzt? | Kapitel 1 und 5 |
| 2 | Der Betreiber ist nicht erreichbar. Wer übernimmt? | Kapitel 0 und 1B |
| 3 | Muss ich jetzt die Feuerwehr alarmieren? | Kapitel 1 |
| 4 | Wohin schicke ich die Gäste? | Kapitel 4 und 5 |
| 5 | Was muss der Platzwart bei Stufe 2 tun? | Dok. 40 |
| 6 | Was macht die Rezeption bei einer Evakuierung? | Dok. 50 |
| 7 | Wem melde ich, dass meine Zone geräumt ist? | Kapitel 1A, Prozess R (R6), Prozess V (V2) |
| 8 | Wie prüfe ich, ob alle Gäste an der Sammelstelle sind? | Kapitel 3, Prozess V (V3, E8, V5, V6) |
| 9 | Das Wasser geht zurück. Dürfen die Gäste wieder auf ihre Plätze? | Kapitel 1B |
| 10 | Auf welcher Höhe liegt M3? | Dok. 80, 434,70 m ü. M. |
| 11 | Kontrollfrage Wo ist die Ausweichsammelstelle? | Nicht eingetragen, Kapitel 5 |
| 12 | Kontrollfrage Was macht die Schichtleitung bei Stufe 3? | Funktion gibt es nicht, Kapitel 0 |
| KI-Modell | Rechner | Richtige Fundstelle | Entscheidende Stelle zuerst | Kontrollfragen | Antwortzeit |
|---|---|---|---|---|---|
| Qwen 3.8 27B | Mac mini M4 Pro | 12 von 12 | 12 von 12 | 2 von 2 | unter 1 Min. |
| Qwen 3.5 9B | Mac mini M4 Pro | 11 von 12 | 7 von 12 | 2 von 2 | unter 1 Min. |
Jede Antwort wird in vier Punkten geprüft: Nennt sie das richtige Dokument und den richtigen Abschnitt? Stimmt der wiedergegebene Inhalt? Ist nichts dazugekommen, was nicht im Plan steht? Führt der Knopf zur Quelle ins richtige Dokument?
Was der Test zeigt
Im neuen Chat hat keines der beiden KI-Modelle etwas erfunden. Den Unterschied machen Reihenfolge und Vollständigkeit: Das grössere Modell setzte bei allen zwölf Fragen die entscheidende Stelle an den Anfang, das kleinere bei sieben.
Die Fundstellen. Qwen 3.8 zeigte jedes Mal die Stelle, die die Frage beantwortet, und darunter, was dazugehört. Auf die Frage nach der Feuerwehr kam zusätzlich die Sofortregel: Jede anwesende Person darf bei unmittelbarer Gefahr den Notruf auslösen. Qwen 3.5 fand bei elf von zwölf Fragen passende Stellen, ordnete sie aber oft nach. Auf die Frage, wohin die Gäste gehen, stand der obere Parkplatz an fünfter Stelle.
Die falsche Fundstelle. Auf die Frage, wem man eine geräumte Zone meldet, zeigte Qwen 3.5 drei Stellen zur Liste an der Sammelstelle. Die Antwort aus dem Plan, die Einsatzleitung, fehlte. Wer nur den ersten Eintrag liest, meldet an der Rezeption.
Die Kontrollfragen. Beide Modelle zeigten die leere Zeile der Ausweichsammelstelle und nannten keinen Ort. Beide erkannten, dass der Plan keine Schichtleitung kennt, und zeigten den Satz, der das festhält.
Der lange Chat. Ein Befund ergab sich nebenbei. Stellt man dem kleineren Modell alle Fragen im selben Chat, verlässt es nach wenigen Antworten die verlangte Form und formuliert selbst. Dabei wies es dem Platzwart die Warnung der Gäste zu, die im Plan bei der Rezeption liegt, und erfand eine Aufgabe beim Voralarm. Im neuen Chat blieb es bei derselben Frage beim Plan.
Jede Frage lief mit jedem Modell in einem neuen Chat. Wie im Hardwarevergleich gilt: Ein einzelner gelungener Durchlauf beweist nichts. Der Test lief mit zehn Dokumenten und einer Person. Wie die Suche bei Hunderten von Dokumenten trägt, zeigt er nicht.
Zwischen den beiden Modellen ändern sich Grösse und Generation. Welcher Faktor einen Unterschied bewirkt, trennt dieser Test nicht.
Was daraus folgt
Ein Suchassistent bewährt sich dort, wo der Mensch keine Zeit hat. Er nennt das zuständige Dokument in Sekunden, und die verantwortliche Person liest die Massnahme an der Quelle. Wer unter Druck nur den ersten Eintrag liest, braucht ein KI-Modell, das die entscheidende Stelle nach oben setzt. Im Test schaffte das zuverlässig nur das grössere. Und jede neue Frage gehört in einen neuen Chat.
Was nicht in der Wissensbasis hinterlegt ist/nicht in einem Dokument steht, findet auch der Suchassistent nicht. Deshalb gehören Kontrollfragen in jeden Test, bevor ein Team im Ernstfall mit der Anwendung arbeitet.
Weiterlesen: