Mein Notebook und mein Mac mini haben beide 64 GB Arbeitsspeicher. Trotzdem brauchte das eine für dasselbe Worddokument vier Minuten, das andere eine.
Ich habe denselben Auftrag auf drei Rechnern ausgeführt
Der Auftrag: Erstelle ein Einarbeitungsblatt für einen neuen Mitarbeiter. Im Test jeweils der Platzwart und die Rezeption eines Campingplatzes. Grundlage ist ein Krisenszenario Hochwasser in zehn Dokumenten. Enthalten sind Tabellen, Text, eine Grafik und ein Prozessablauf. Ziel ist, mit dem KI-basierten Assistenten Zeit zu sparen bei der Erstellung von Einarbeitungsblättern. Die Einarbeitungsblätter entstehen auf der Grundlage der Wissensbasis, die im Bedarfsfall aktualisiert wird. Im Chat soll so eine Word-Datei zum Download und zur Prüfung für den Verantwortlichen entstehen, mit allen Aufgaben des Platzwarts und der Quelle dazu. Den Testfall beschreibe ich in einem anderen Blogartikel.
Das Notebook (Lenovo Thinkpad P1, Gen 8) brauchte dafür vier Minuten, der PC (Alienware Dell, RTX 3080) eine. Auf dem Mac mini (Pro M4) entstanden die Blätter für alle sieben Rollen ohne inhaltlichen Fehler. Und auf zwei Rechnern erfand ein Modell sämtliche Aufgaben, mit korrekter Quellenangabe dahinter.
Daraus folgt: Der Speicher eines Rechners bestimmt, welches Sprachmodell darauf Platz hat. Das Modell bestimmt, ob das Blatt stimmt. Wer einen Rechner für lokale KI beschafft, klärt deshalb zuerst die Aufgabe, dann das Modell und erst zuletzt das Gerät.
Wie das Worddokument entsteht
Zwei Programme teilen sich die Arbeit. Das Sprachmodell liest die Dokumente und sucht heraus, welche Aufgaben die Rolle hat, beim Platzwart etwa PW1 bis PW6. Ein kleines Zusatzprogramm, das Werkzeug, macht daraus die Word-Datei, immer im selben Aufbau. Vorher prüft es, was das Modell liefert. Kommt keine Aufgabe an, schickt es die Lieferung mit einer Fehlermeldung zurück. Fehlt nur ein Teil, erstellt es das Worddokument trotzdem und markiert die Lücke als offenen Prüfpunkt. Das Werkzeug erkennt also, ob etwas fehlt. Ob stimmt, was im Blatt steht, prüft der/die Verantwortliche.
Was «in den Speicher passen» heisst
Ein Sprachmodell rechnet am schnellsten im Speicher der Grafikkarte.
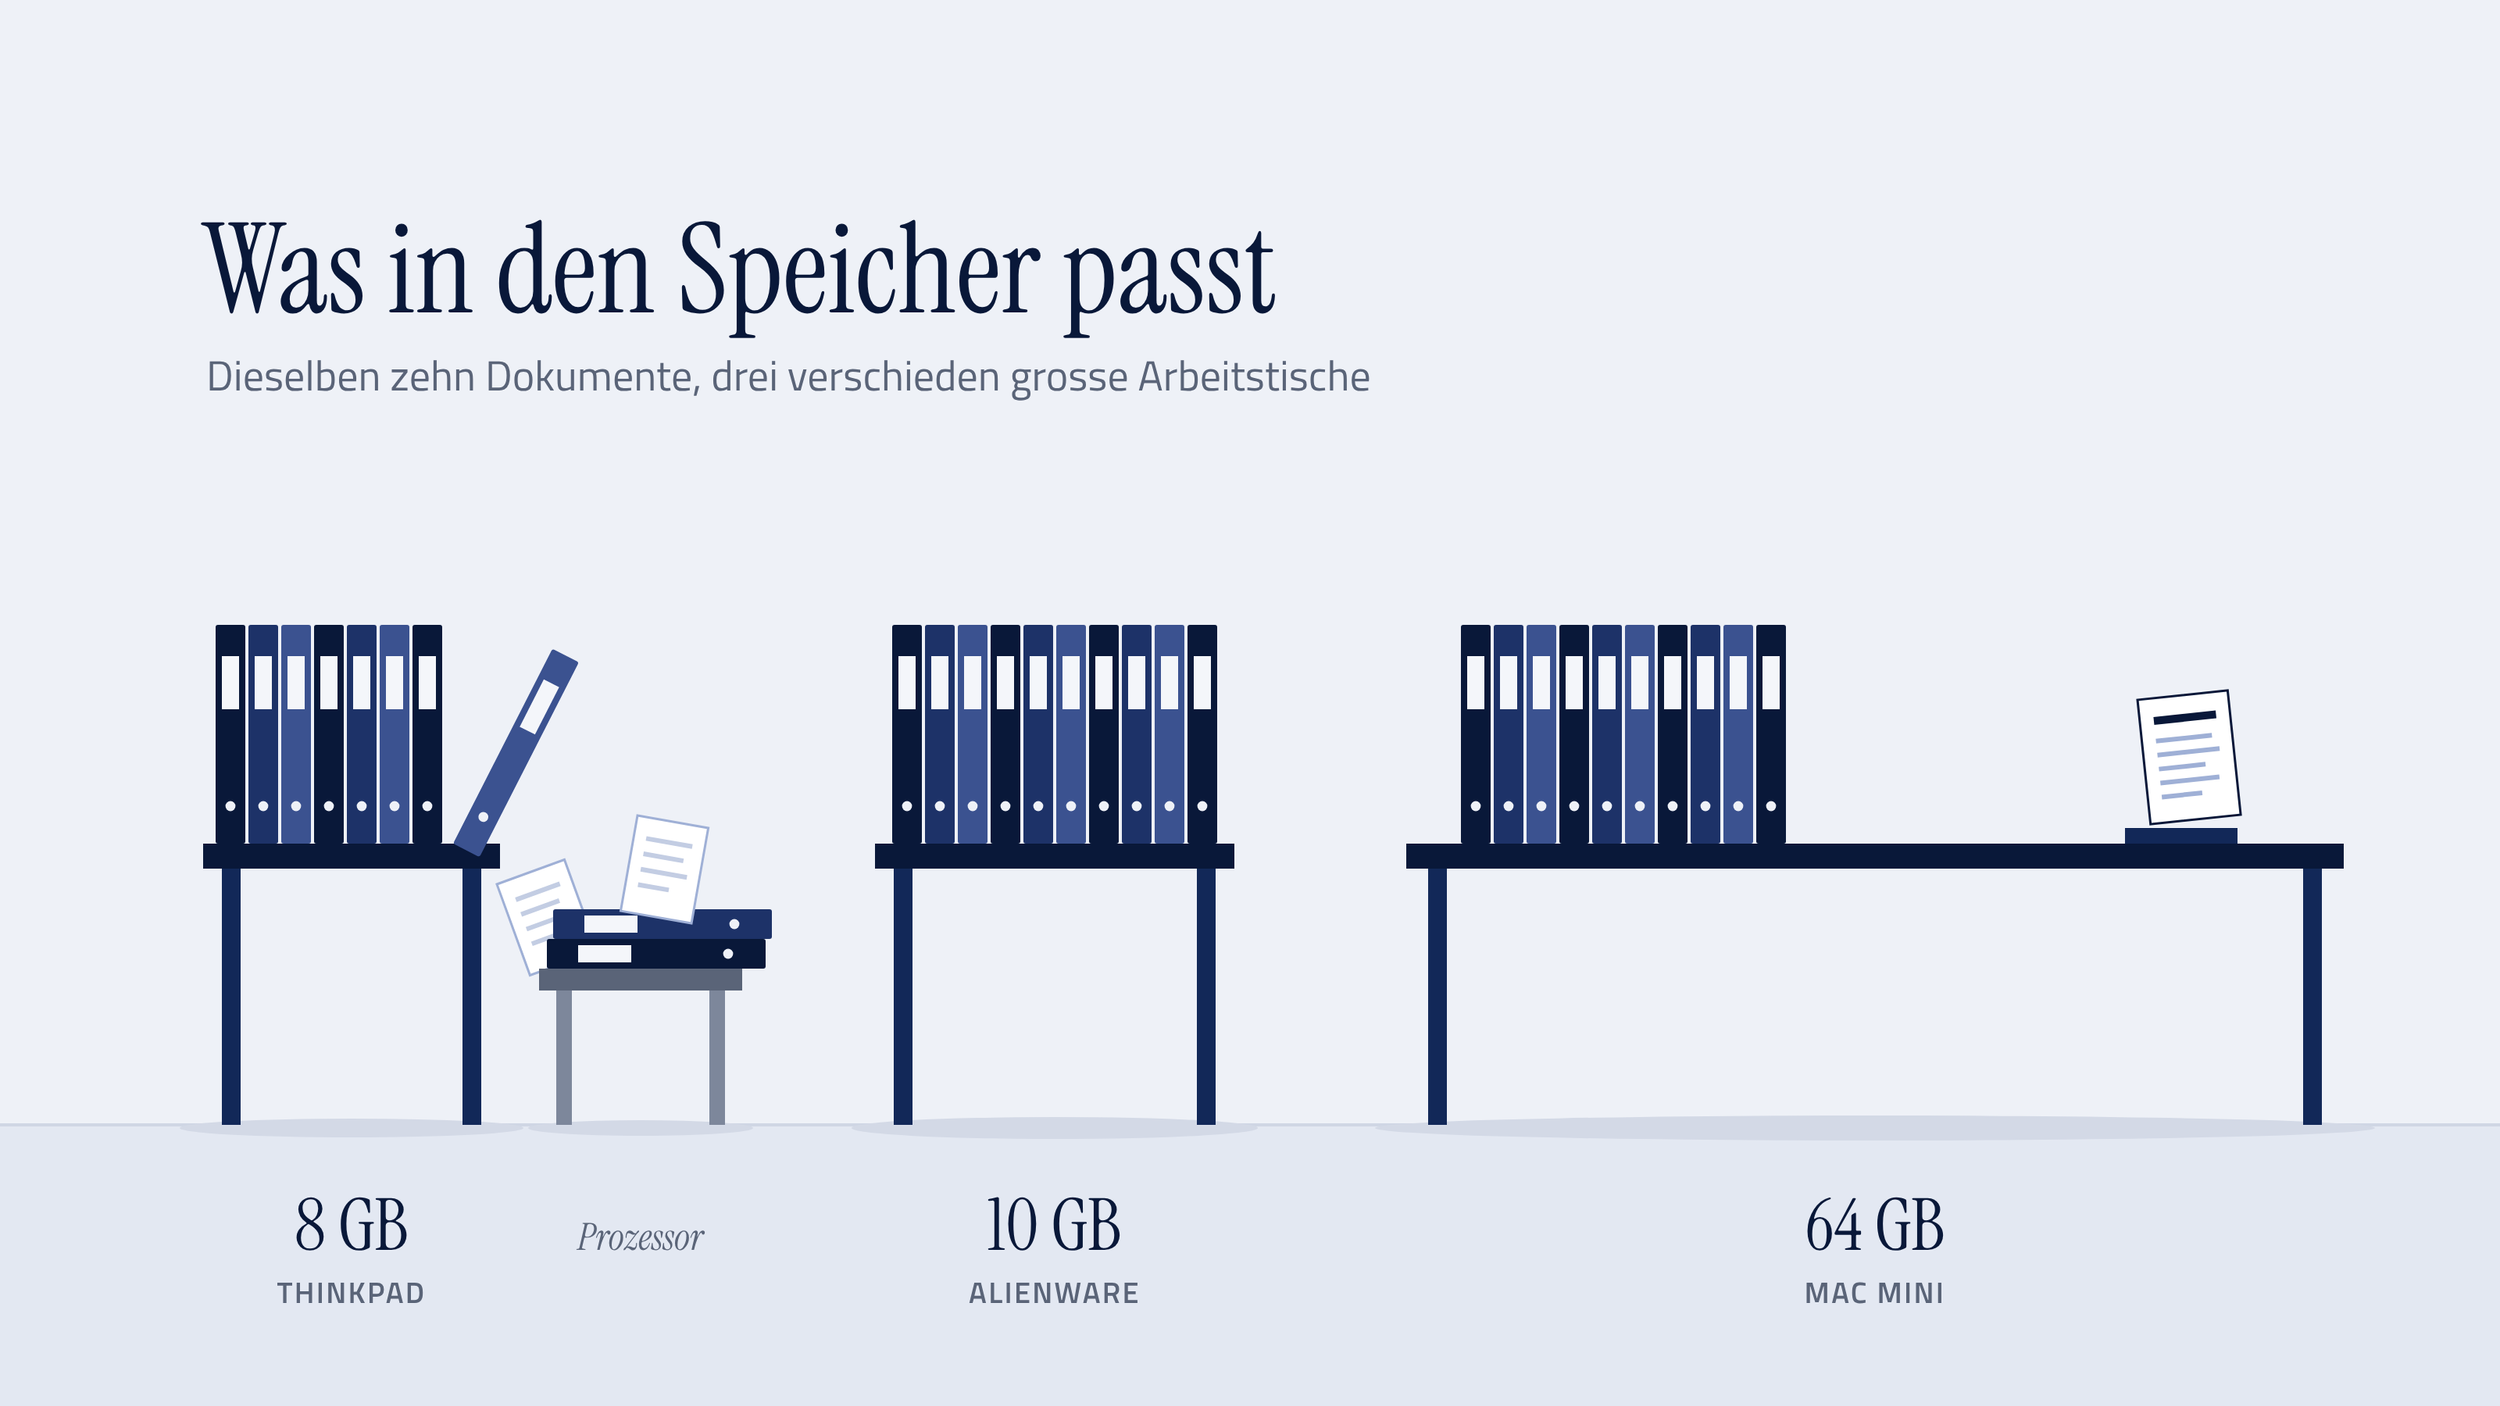
Man kann ihn sich als Arbeitstisch vorstellen. Liegen Modell und Dokumente ganz auf dem Tisch, geht die Arbeit zügig. Ist der Tisch zu klein, muss ein Teil der Arbeit zum Prozessor ausweichen. Der rechnet um ein Vielfaches langsamer.
Wie viel Platz ein Modell braucht, hängt von seiner Grösse ab. Fachleute messen sie in Milliarden Parametern. Grob gilt: Je grösser das Modell, desto mehr Speicher braucht es.
Meine drei Rechner haben sehr unterschiedlich grosse Tische:
Notebook, Lenovo ThinkPad P1 Gen 8: 8 GB auf der Grafikkarte
PC, Alienware mit RTX 3080: 10 GB auf der Grafikkarte
Mac mini M4 Pro: 64 GB, die sich Prozessor und Grafik teilen
Das Notebook: richtig, aber langsam
Auf dem Notebook lief ein Modell mit 9 Milliarden Parametern. Es übernahm die Aufgaben wörtlich und erfand nichts. Aber es passte nicht ganz auf den Tisch. Rund 15 Prozent der Arbeit übernahm der Prozessor, und ein Blatt dauerte rund vier Minuten. Dafür war es vollständiger als das Blatt vom PC.
Ein kleineres Modell mit 4 Milliarden Parametern war nach einer Minute fertig. Es nahm Stichworte aus einem anderen Dokument, verteilte sie auf die Aufgaben PW1 bis PW6 und erfand die Auslöser dazu. Hinter jeder Zeile stand der Verweis auf die richtige Checkliste.
Der PC: schnell, aber nicht intelligenter
Auf dem PC passt das Modell mit 9 Milliarden Parametern in den Grafikspeicher. Dort stand dasselbe Worddokument nach etwa einer Minute. Die Aufgaben stimmten, einzelne Regeln fehlten.
Zuerst hatte ich dort ein grösseres, aber älteres Modell ausprobiert, mit 14 Milliarden Parametern. Es erfand aber Antworten im Worddokument, wie Lärmmessung, Luftqualität, jede Zeile mit Verweis auf die richtige Checkliste. Die Aufgabe, die Leben schützt, fehlte. Was dieser Fall über Quellenangaben zeigt, beschreibe ich im Beitrag “Fund, Fassung, Befund”.
Mehr Parameter machen ein Modell also nicht intelligenter. Auch die Generation zählt.
Der Mac mini: Platz für ein grösseres Modell
Mit 64 GB hat der Mac mini Platz für ein Modell mit 27 Milliarden Parametern. Es belegt rund 27 GB und passt ganz hinein. Es erstellte die Worddokumente für alle sieben Rollen ohne inhaltlichen Fehler, jedes in einer bis drei Minuten.
Zur Gegenprobe lief auf dem Mac auch das Modell mit 9 Milliarden Parametern. Der grosse Speicher machte es nicht intelligenter. Es ordnete eine Aufgabe der falschen Rolle zu und erfand Ergänzungen. Der Rechner verändert zwar das Tempo. Das Modell verändert erst das Ergebnis.
Zwei Einschränkungen gehören dazu. Das grosse Modell ist auch aktueller. Ob Grösse oder Generation den Unterschied macht, trennt mein Test nicht. Und auch das grosse Modell erfand einmal ein ganzes Blatt, der nächste Lauf war wieder fehlerfrei.
Deshalb ist es wichtig, ein Anwender oder eine Anwenderin prüft jede Ausgabe eines KI-Chats und die Worddokumente an der Quelle.
Alle Läufe im Überblick (mit einheitlichem Skill und Werkzeug)
| Rechner | Speicher für das Modell | Modell | Dauer pro Blatt | Ergebnis |
|---|---|---|---|---|
| Lenovo ThinkPad P1 Gen 8 | 8 GB Grafikspeicher | 4 Mrd. Parameter | ca. 1 Min. | Aufgaben erfunden, mit Verweis auf die richtige Checkliste |
| Lenovo ThinkPad P1 Gen 8 | 8 GB Grafikspeicher | 9 Mrd. | ca. 4 Min. | Aufgaben wörtlich, nichts erfunden |
| Dell Alienware, RTX 3080 | 10 GB Grafikspeicher | 14 Mrd., ältere Generation | 3–5 Min. | Aufgaben erfunden |
| Dell Alienware, RTX 3080 | 10 GB Grafikspeicher | 9 Mrd. | ca. 1 Min. | Aufgaben wörtlich, einzelne Regeln fehlen |
| Apple Mac mini M4 Pro | 64 GB gemeinsamer Speicher | 9 Mrd. | ca. 1 Min. | Aufgabe falscher Rolle zugeordnet, Ergänzungen erfunden |
| Apple Mac mini M4 Pro | 64 GB gemeinsamer Speicher | 27 Mrd., neuere Generation | 1–3 Min. | alle sieben Rollen ohne inhaltlichen Fehler, ein Ausreisser |
Was der Test nicht zeigt
In meiner Testreihe stellte ich allein eine Anfrage nach der anderen. Arbeitet ein Team gleichzeitig, braucht jede Anfrage zusätzlichen Speicher. Ob ein Rechner dafür reicht, zeigt nur ein Test unter echten Bedingungen.
Rufen mehrere Arbeitsplätze die Wissensbasis auf, wird der Rechner zum Server. Dann braucht es Regeln für Standort, Netzwerk, Wartung und Zuständigkeit. Auch Updates gehören dazu: Ein automatisches Update hat mir nämlich einmal eine Wissensbasis entfernt. Seither halte ich die Version fest. Mehr dazu im Beitrag “KI-Sicherheit: Entscheidend ist die Kontrolle über Daten und Zugriffe”.
Und keine noch so hochwertige Hardware rettet schlecht aufbereitete Dokumente. Davon handeln die Beiträge in der Kategorie Dokumente.
Erst die Aufgabe, dann das Gerät
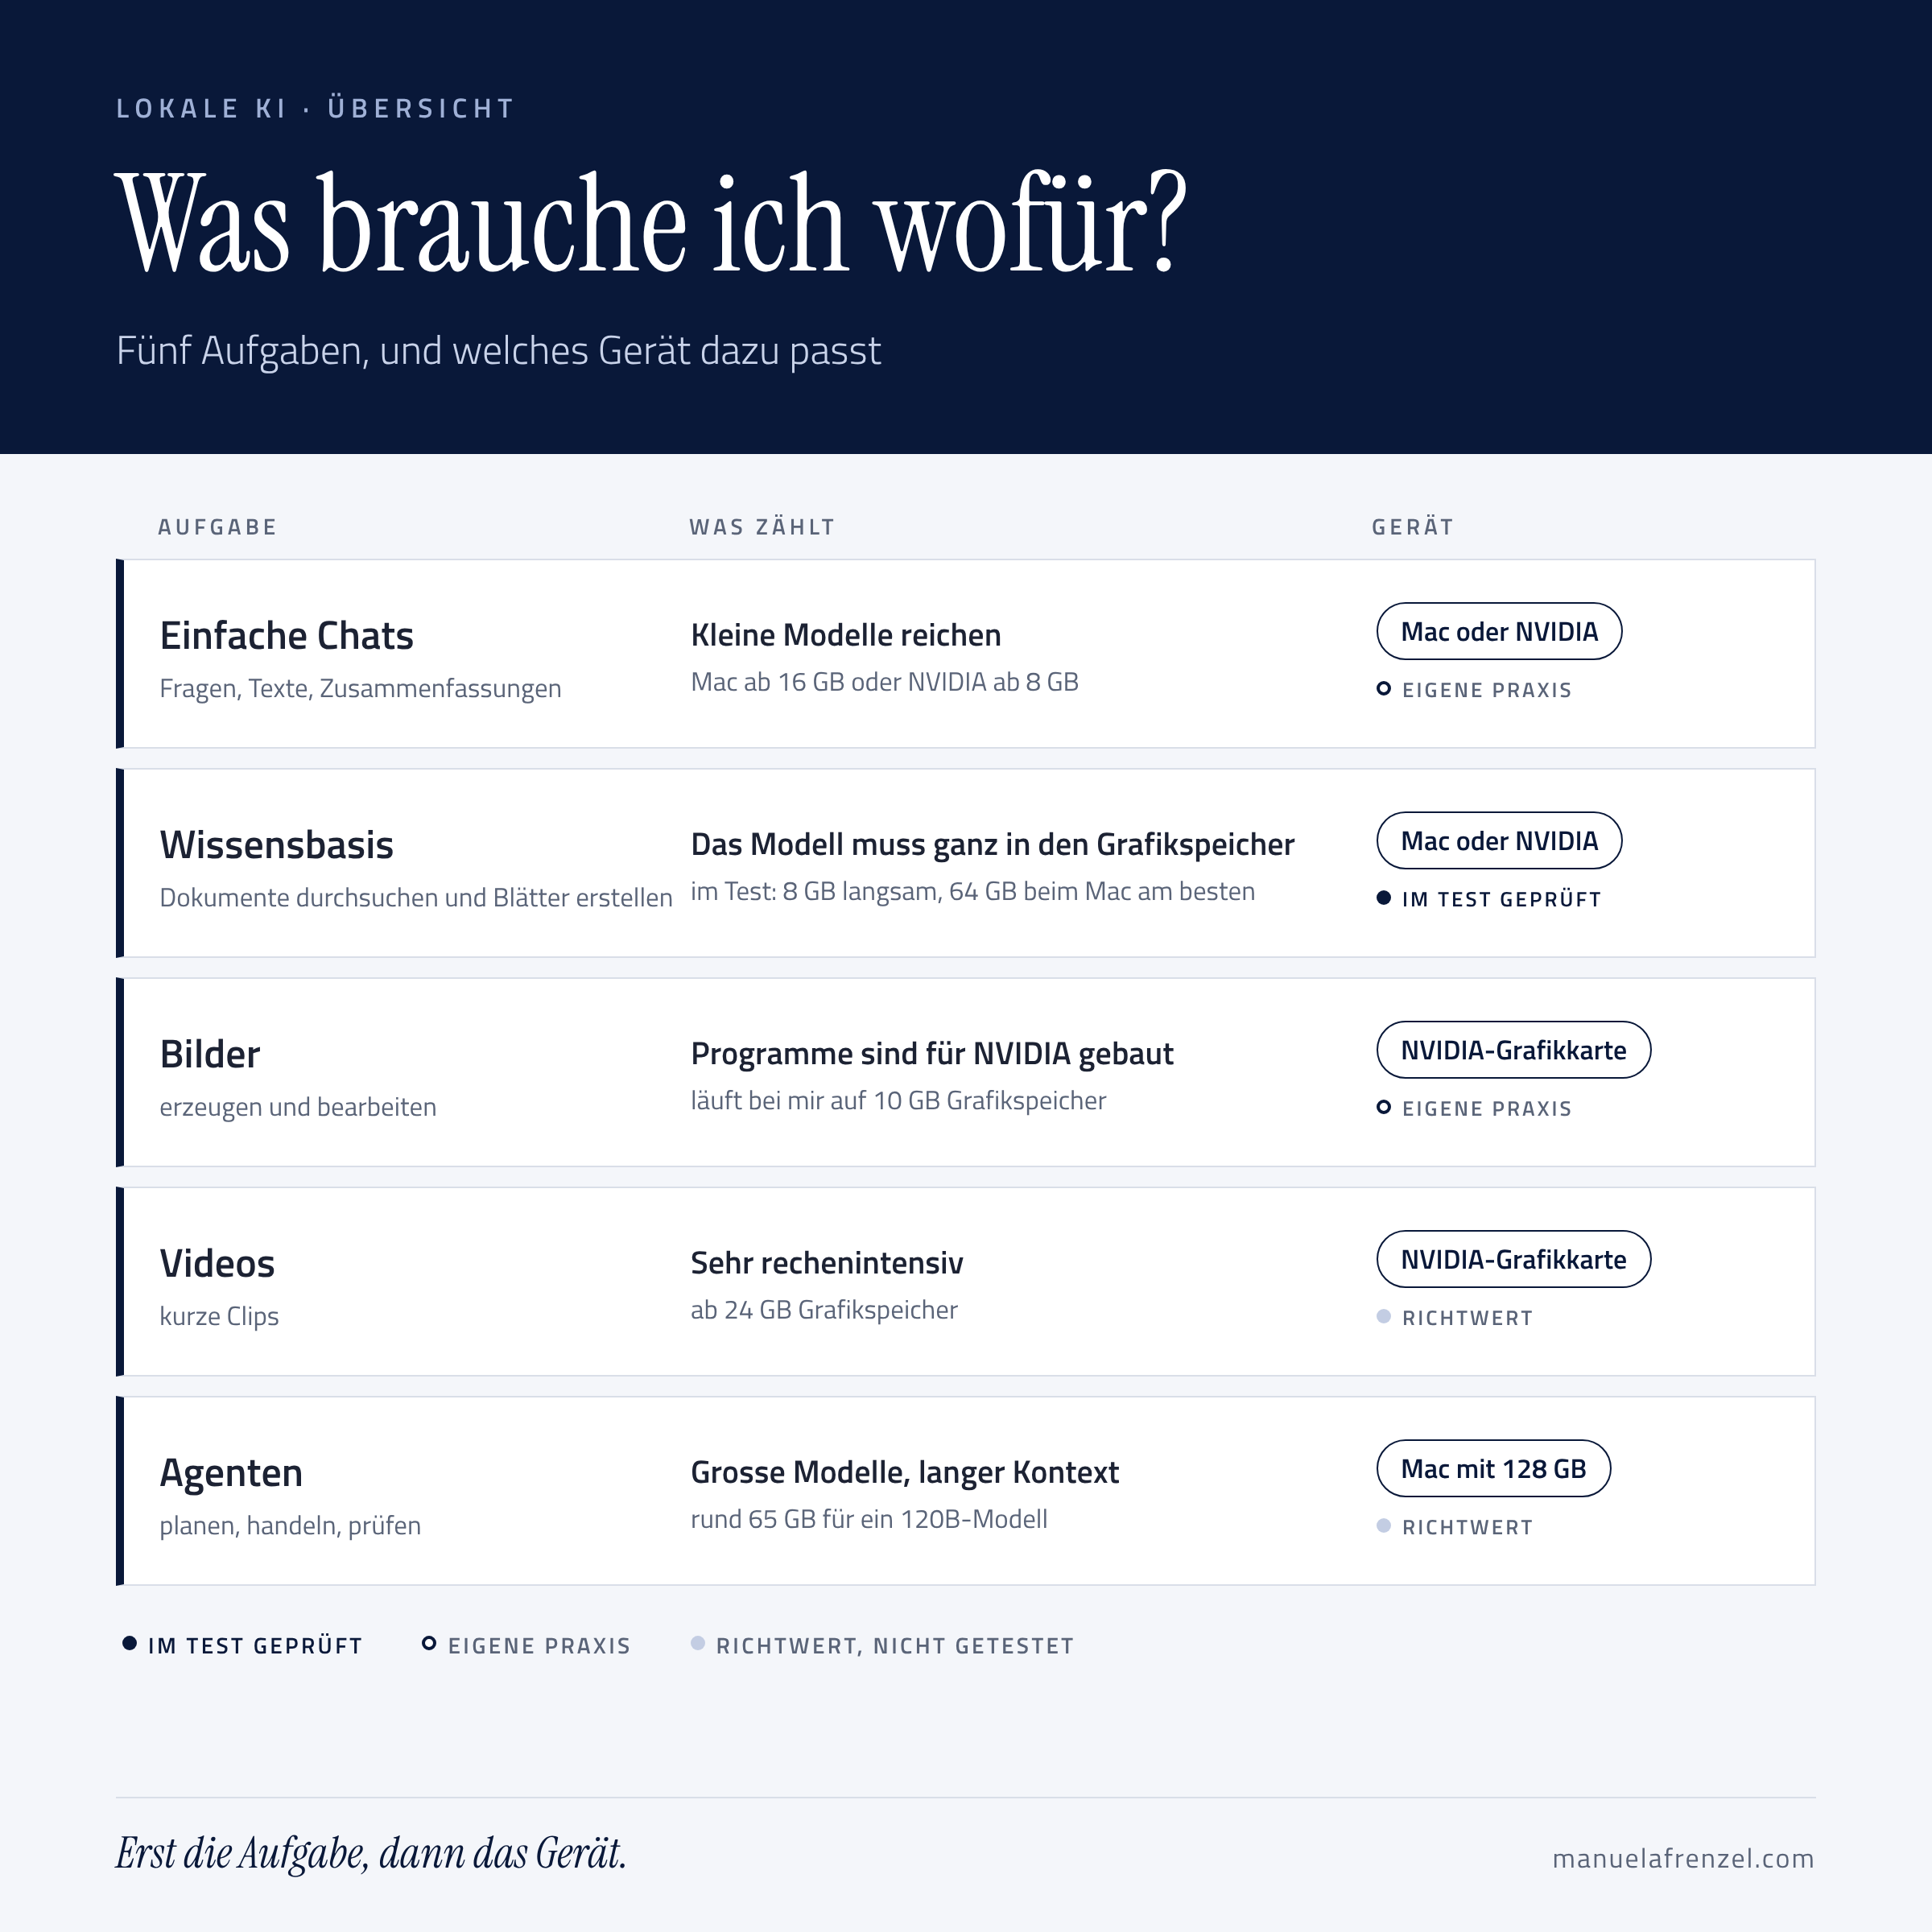
Aus meinem Test ergibt sich eine Reihenfolge für die Beschaffung, in drei Fragen
Was soll die KI tun? In meinem Test sollte sie aus zehn Dokumenten ein Einarbeitungsblatt als Word-Dokument erstellen. Das verlangt mehr als eine Suche, bei der sie nur die passende Stelle findet.
Welches Modell schafft das? Das zeigt nur ein Versuch mit den eigenen Dokumenten. Bei mir erfand das kleinste Modell sämtliche Aufgaben. Das mittlere arbeitete mal richtig, mal mit Fehlern. Erst das Modell mit 27 Milliarden Parametern erstellte alle sieben Blätter ohne inhaltlichen Fehler.
Welcher Rechner fasst dieses Modell? Es muss ganz in den Grafikspeicher passen. Das Modell mit 27 Milliarden Parametern braucht rund 27 GB. Von meinen drei Rechnern bietet das nur der Mac mini.
Der Tisch (siehe Blogheadergrafik) entscheidet, welches Modell darauf Platz hat. Ob das Word-Dokument stimmt, zeigt erst der Blick in die Quelle.
Quellen und weiterführende Hinweise
Ollama: Context Length
Ollama: FAQ – gleichzeitige Anfragen, Speicherbedarf und Warteschlangen
Open WebUI: Retrieval-Augmented Generation
Eidgenössischer Datenschutz- und Öffentlichkeitsbeauftragter: Leitfaden zu den technischen und organisatorischen Massnahmen des Datenschutzes
Eigenes Testprotokoll, 21. bis 26. Oktober 2026: drei Rechner, sieben Rollen, Modelle mit 4 bis 27 Milliarden Parametern (nicht veröffentlicht).