
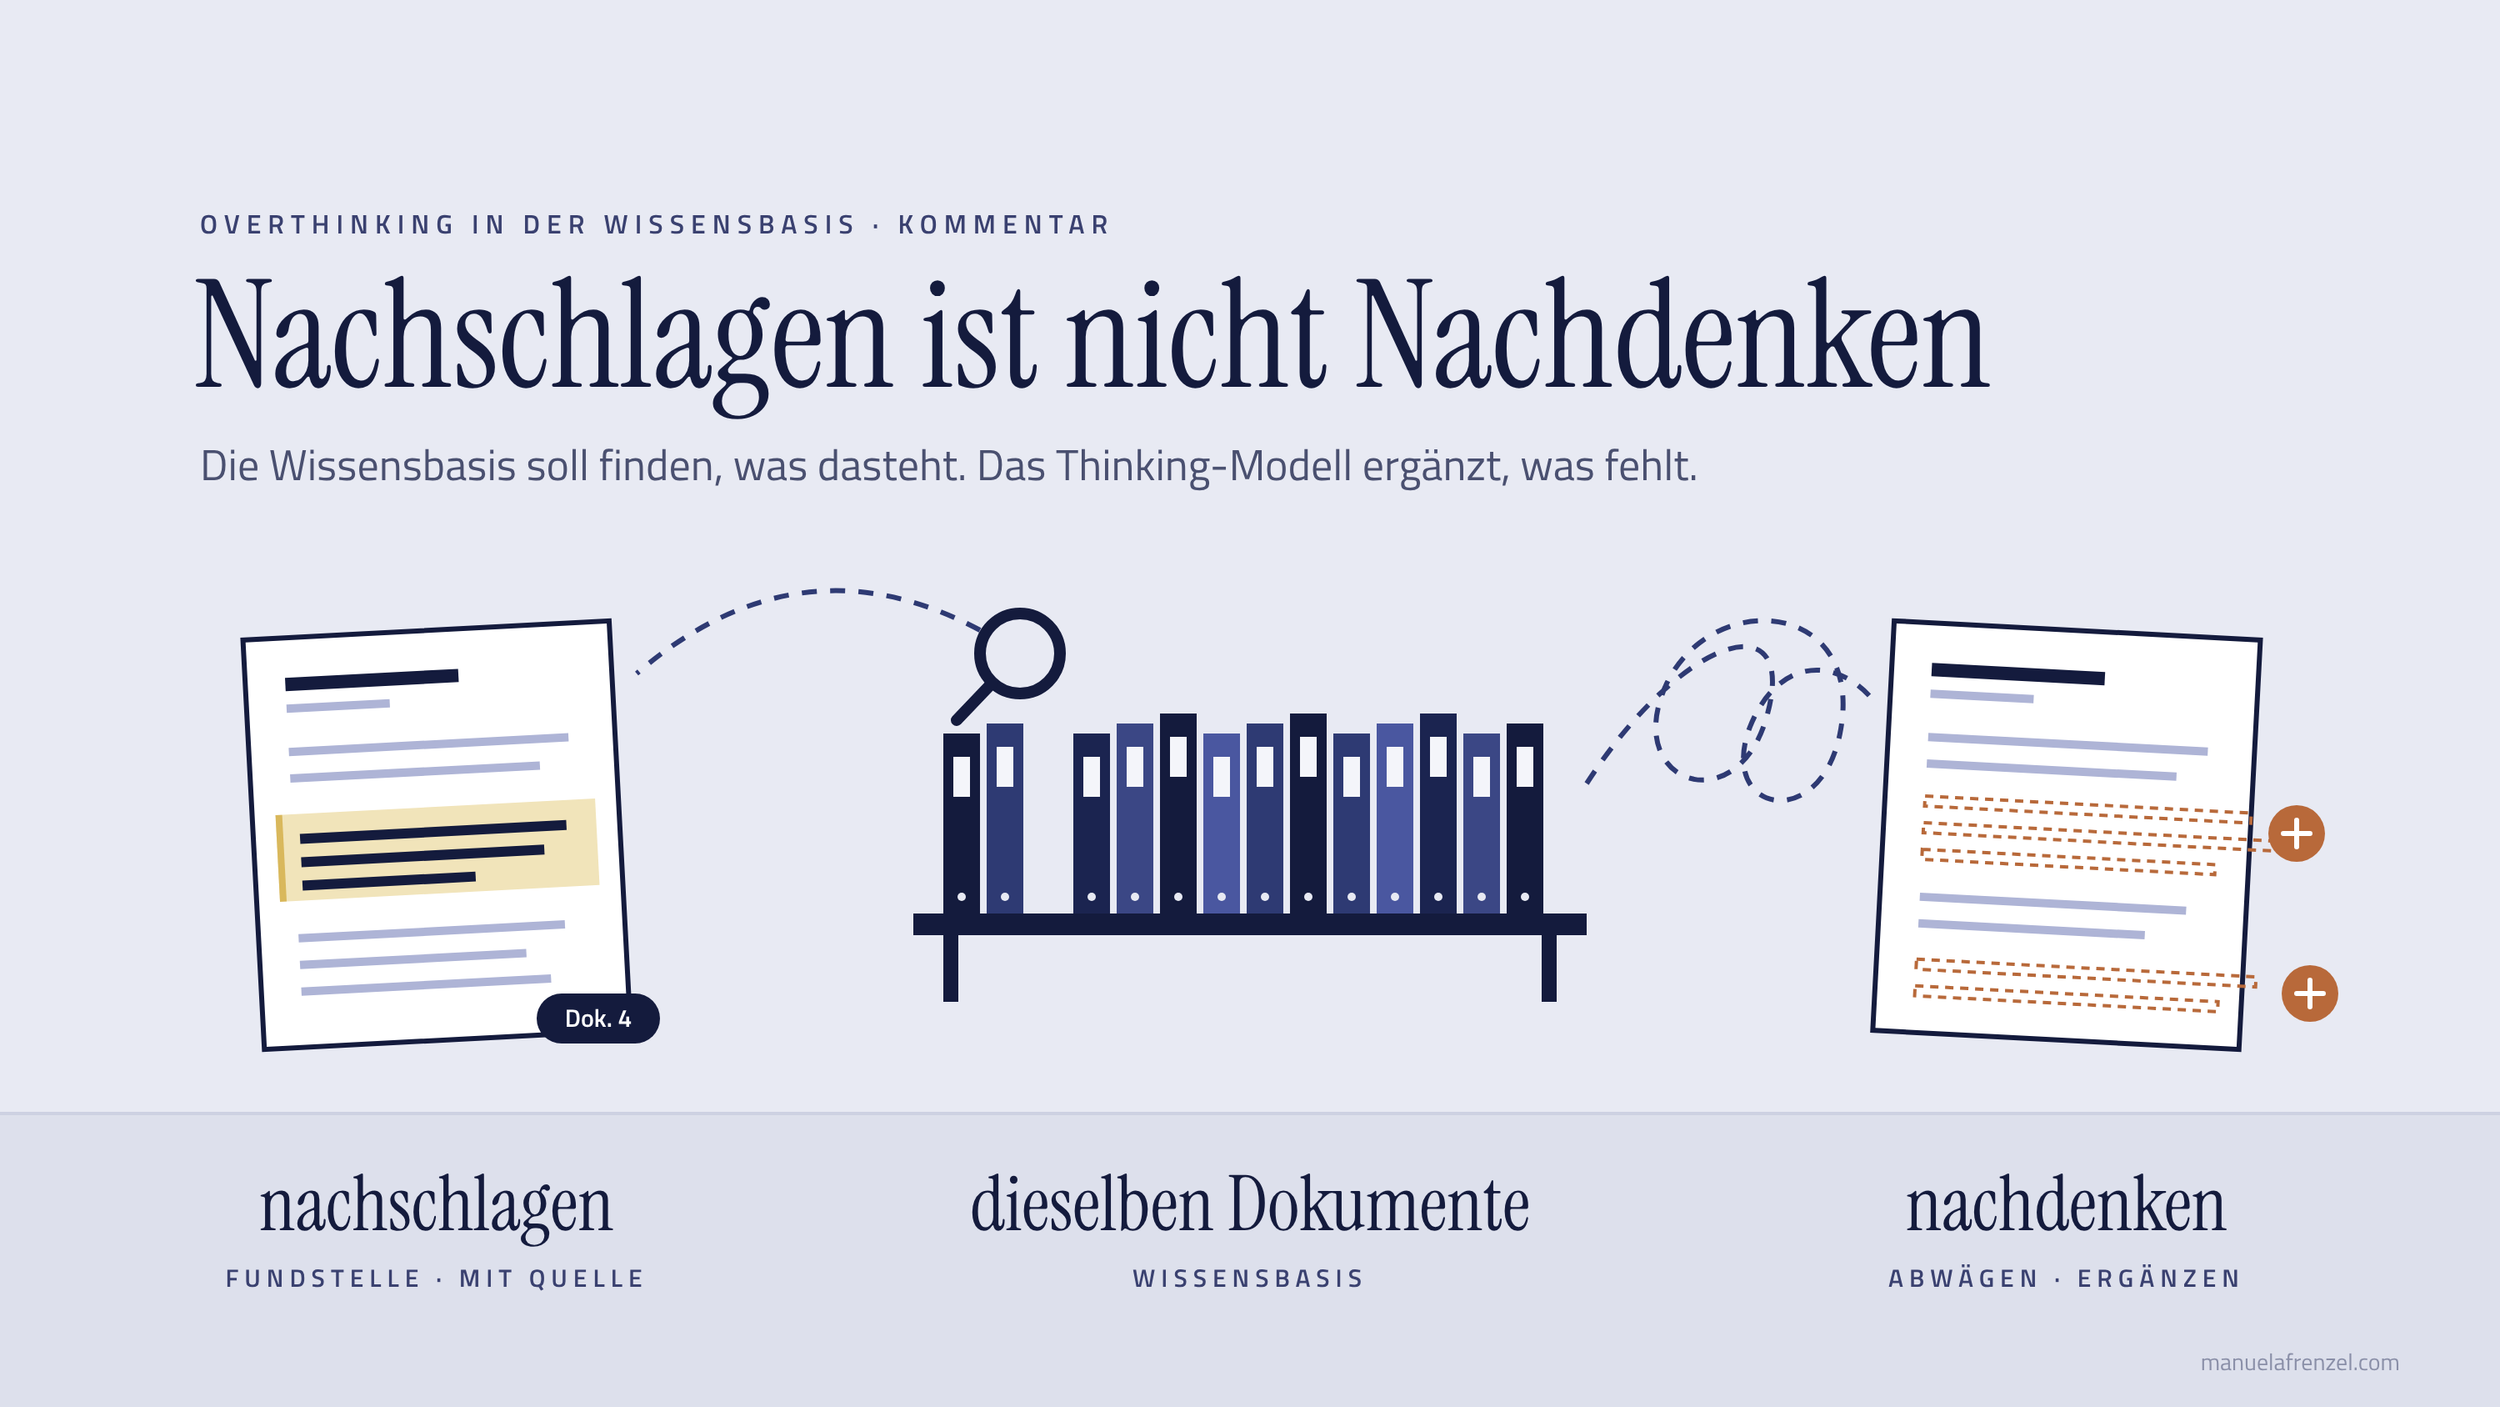
Wer eine KI-Wissensbasis aufbaut, will verlässliche Antworten aus den eigenen Dokumenten.
Wer im Prozessportal nach einer Weisung sucht, erwartet das gültige Dokument. Eine Zusammenfassung mit eigenen Ergänzungen erwartet niemand. Dasselbe gilt für eine KI-Wissensbasis, die als Rechercheassistent Dokumente finden und kein eigenes Produkt erstellen soll: Das KI-Modell durchsucht die Unterlagen, gibt die passende Stelle wieder und verlinkt auf das Dokument. So lässt sich jede Antwort mit eigenen Augen nachprüfen.
Thinking-Modelle arbeiten anders: Sie denken nach. In einer verborgenen oder offenen Denkphase wägen sie ab, ziehen Schlüsse und ergänzen. Für Mathematik, Programmcode oder schwierige Abwägungen ist das sinnvoll. In einer Wissensbasis, in der das KI-Modell Dokumente auffindbar machen soll, wird genau dieses Verhalten zum Problem.
Was die Messungen von Vectara zeigen
Das Analyseunternehmen Vectara prüft regelmässig, wie treu KI-Modelle beim Zusammenfassen bei ihrer Vorlage bleiben. Das Thinking-Modell DeepSeek-R1 fügte in 14,3 Prozent der Fälle Inhalte hinzu, die gar nicht im Ausgangstext standen. Sein Vorgänger DeepSeek-V3 – ein Modell ohne Denkphase – kam auf lediglich 3,9 Prozent.
Aufschlussreich ist die Art dieser Fehler: Der grösste Teil war sachlich richtig, stand aber schlicht nicht in der Vorlage. Das Modell schrieb es aus eigenem Trainingswissen dazu. Vectara nennt solche Abweichungen “gutartige” Halluzinationen.
Für den Betrieb einer Wissensbasis sind solche Ergänzungen jedoch keineswegs gutartig. Eine Aussage, die in keinem hinterlegten Dokument steht, lässt sich weder belegen noch nachführen, sobald sich eine Vorschrift ändert. Für Behörden und Unternehmen, deren Auskünfte nachvollziehbar sein müssen, ist das ein Risikofaktor, selbst wenn die ergänzte Aussage zufällig stimmt.
Die Denkphase allein erklärt den Befund allerdings nicht vollständig. Vectara führt einen Teil der Abweichungen auf das spezifische Training von DeepSeek-R1 zurück. Bei OpenAI fiel der Abstand kleiner aus: 2,4 Prozent beim Thinking-Modell o1 gegenüber 1,5 Prozent bei GPT-4o. In der System Card zu o3 hält OpenAI mit Blick auf Wissensfragen fest: Das Modell antwortet häufiger als sein Vorgänger und liegt dabei öfter richtig, aber eben auch öfter falsch.
Ein KI-Modell, das mehr ergänzt, als in den Unterlagen steht, ist als KI-basierter Suchassistent ungeeignet.
Konsequenzen für den Betrieb einer Wissensbasis
Für den Betrieb einer KI-gestützten Wissensbasis folgen daraus drei praktische Konsequenzen:
Die Denkphase verlangt eine bewusste Entscheidung.
Bei lokalen Installationen (etwa via Ollama) ist die Denkphase für unterstützte Modelle standardmässig aktiviert. In Benutzeroberflächen wie Open WebUI lässt sie sich manuell deaktivieren. Hier zählt die Ebene: Wer sie am Grundmodell global abschaltet, entzieht sie allen geklonten Anwendungen. Sauberer ist eine eigene KI-Modellvariante als Klon für die Wissensbasis, mit deaktivierter Denkphase und abgestimmter Systemanweisung.
Die Systemanweisung setzt enge Grenzen.
Für eine Such-Wissensbasis muss die Systemanweisung das Modell strikt an die Vorlage binden. Ein funktionierendes Muster lautet:
“Antworte ausschliesslich mit Inhalten aus den bereitgestellten Dokumenten. Verlinke zu jeder Aussage das Quelldokument. Sobald Fundstelle und Link genannt sind, beende die Antwort. Keine Einleitung, keine zusammenfassenden Ergänzungen. Steht die Antwort nicht in den Unterlagen, antworte exakt mit: In der hinterlegten Wissensbasis habe ich kein passendes Dokument gefunden.”
Die Ausweichantwort ist die entscheidende Regel: Sie verhindert, dass das Modell Lücken mit eigenem Trainingswissen auffüllt.
Nachdenken bindet Ressourcen.
Bei Cloud-Anbietern schlagen Denkschritte als ausgegebene Tokens direkt zu Buche. Lokal kostet die Denkphase vor allem Kontextfenster. Da der Platz begrenzt ist, belegen die Denkschritte genau den Raum, den eigentlich die gefundenen Quelldokumente bräuchten. Je länger das Modell nachdenkt, desto weniger Quellentext passt in den Speicher , von den zusätzlichen Wartezeiten ganz zu schweigen.
Der richtige Platz für Thinking-Modelle
Das bedeutet nicht, dass Thinking-Modelle in Wissensbasen keinen Nutzen hätten. Ihr Einsatzbereich liegt jedoch nicht im reinen Nachschlagen, sondern in der syntaktischen und logischen Analyse: Sie eignen sich hervorragend dazu, Richtlinien auf Widersprüche zu prüfen, komplexe Dokumente gegeneinander abzugleichen, Zuständigkeiten aus mehreren Vorschriften herzuleiten oder Entwürfe an der Quelle zu validieren.
Eine Wissensbasis für die reine Dokumentensuche bleibt im Kern ein Prozessportal mit Suchfunktion. Sie muss exakt wiedergeben, was in den Unterlagen steht, und dies direkt am Originaldokument überprüfbar machen. Nachdenken ist sinnvoll, wo Dokumente einander widersprechen oder ein neues Syntheseprodukt aus dem hinterlegten Wissen erstellt werden soll.
Quellen
